

لم تعد المنافسة في الذكاء الاصطناعي تدور فقط حول النماذج الكبيرة القادرة على كتابة النصوص والإجابة عن الأسئلة، بل بدأت تمتد إلى فئة أصغر وأكثر تخصصاً: نماذج لا تُنتج محتوى طويلاً، بل تُصدر تقييماً سريعاً يساعد المنصات على اتخاذ قرار.
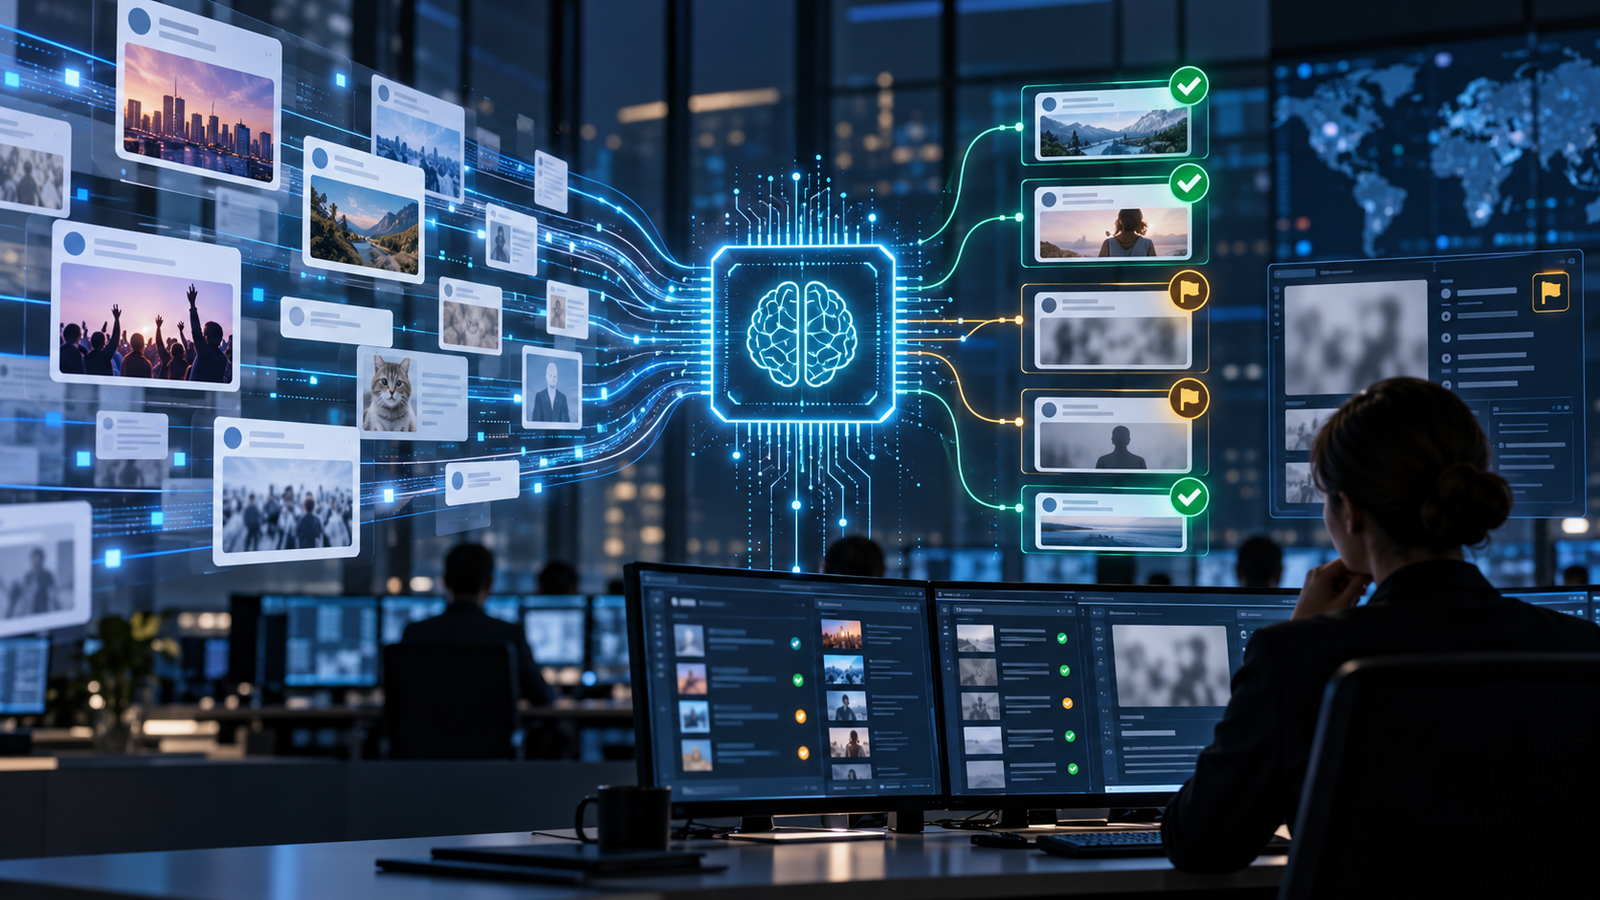
ويظهر هذا التحول بوضوح في مجال مراقبة المحتوى، حيث تتعامل المنصات الرقمية مع كميات ضخمة من المنشورات والرسائل والتعليقات، وتبحث في الوقت نفسه عن أدوات أسرع وأقل كلفة لتطبيق سياساتها.
في هذا السياق، أطلقت «موسوبي لابس» نموذج «PolicyLM-1.7B»، وهو نموذج مفتوح الأوزان مخصص لمهام تصنيف المحتوى وتطبيق سياسات المنصات. وتقوم فكرته على إدخال السياسة المكتوبة بلغة طبيعية أثناء تشغيل النموذج، ليقيّم المحتوى وفقها من دون الحاجة إلى إعادة تدريبه مع كل تعديل في القواعد.
صندوق النقد الدولي يخشى انفجار فقاعة الذكاء الاصطناعي
نموذج صغير لقرارات سريعة
وفقاً لبطاقة النموذج المنشورة على منصة «Hugging Face»، يتكون «PolicyLM-1.7B» من 1.7 مليار معامل، وهو مصمم لمهام تحتاج إلى قرار سريع، مثل الدردشة الحية والتعليقات ومنشورات المستخدمين.
وتقول «موسوبي لابس» إن النموذج يسجل زمناً وسيطاً يبلغ 35 مللي ثانية لكل رسالة قصيرة على وحدة معالجة «NVIDIA L4» عند استخدام ما يصل إلى 6 فئات، و22 مللي ثانية على «H100 PCIe» في اختبارات محددة.
وتتيح الشركة أوزان النموذج بترخيص «Apache-2.0»، ما يسمح للمطورين بتشغيله داخل بنيتهم الخاصة وتقييمه محلياً. كما يدعم النموذج 19 لغة، بينها العربية والإنجليزية والفرنسية والألمانية والروسية والصينية واليابانية والكورية.
لكن هذه الأرقام تبقى نتائج اختبارات معلنة من الشركة، وليست ضماناً لأداء مماثل في كل بيئة تشغيل. وتشير «موسوبي لابس» نفسها إلى أن النموذج لم يُختبر بعد على حركة مرور حقيقية، وأن أداءه قد يتغير بحسب صياغة السياسة واللغة والجهاز وطبيعة المحتوى.
السياسة تصبح جزءاً من التشغيل
الميزة الأبرز في «PolicyLM» ليست حجمه فقط، بل طريقة تعامله مع السياسات. فبدلاً من تدريب نموذج جديد كلما تغيرت قواعد المنصة، يمكن إدخال السياسة نفسها أثناء الاستدلال، على شكل فئات وقواعد قصيرة.
بحسب «موسوبي لابس»، يستطيع النموذج تقييم ما يصل إلى 16 فئة في السياسة الواحدة، وإرجاع درجة من صفر إلى واحد لكل فئة. وبعد ذلك تحدد المنصة العتبة التي يتحول عندها المحتوى إلى حالة مخالفة أو حالة تحتاج إلى مراجعة.
هذا يعني أن النموذج لا يعمل كحكم مستقل بالكامل، بل كطبقة تصنيف تساعد فرق الثقة والسلامة على فرز المحتوى بسرعة. فقد تُحال الحالات الواضحة إلى إجراء آلي، بينما تبقى الحالات الملتبسة أو الحساسة للمراجعة البشرية.
وتكمن أهمية هذا التصميم في أنه يجعل تعديل السياسة أسرع من إعادة بناء نظام كامل. فإذا تغيرت قواعد المنصة بشأن خطاب الكراهية أو الاحتيال أو مشاركة البيانات الخاصة، يمكن اختبار صياغة جديدة للسياسة ومعرفة أثرها على النتائج قبل اعتمادها.
مليارات الذكاء الاصطناعي تتدفق.. متى تتحول إلى أرباح؟
السرعة لا تكفي وحدها
تُظهر بيانات «موسوبي لابس» أن النموذج يحقق سرعة أعلى من نماذج أكبر في بعض الاختبارات، لكنه لا يتفوق دائماً في الدقة. ففي اختبار السياسات المخصصة الذي نشرته الشركة، سجل «PolicyLM-1.7B» دقة بلغت 0.842، مقابل 0.909 لنموذج أكبر هو «gpt-oss-safeguard-20B»، لكنه كان أسرع بكثير في زمن الاستجابة.
وهنا تظهر المفاضلة الأساسية في هذا السوق: المنصات لا تبحث دائماً عن أعلى دقة مطلقة، ولا عن أسرع نموذج فقط، بل عن توازن بين السرعة والكلفة والدقة وقابلية تعديل السياسات.
فمراقبة المحتوى ليست مهمة تقنية صافية. الخطأ فيها له تكلفة اقتصادية وتشغيلية وسمعة أيضاً. السماح بمحتوى مخالف قد يعرّض المنصة لمخاطر تنظيمية أو إعلانية، بينما حجب محتوى مشروع بالخطأ قد يضر المستخدمين ويزيد الاعتراضات ويخلق عبئاً على فرق الدعم والمراجعة.
عبارة «الذكاء الاصطناعي» ولوحة مفاتيح، ويد آلية تظهر ضمن صورة ملتقطة في 23 سبتمبر 2026.
سوق الثقة والسلامة يدخل مرحلة جديدة
من الناحية الاقتصادية، يمكن لهذه النماذج أن تغيّر طريقة بناء أنظمة الثقة والسلامة داخل المنصات. فبدلاً من الاعتماد الكامل على المراجعة البشرية أو على نماذج لغوية عامة وكبيرة، يمكن استخدام نماذج صغيرة ومتخصصة كطبقة أولى لتصنيف المحتوى.
هذه الطبقة قد تساعد في خفض زمن المعالجة، وتوجيه المراجعين البشريين إلى الحالات الأصعب، وتقليل الحاجة إلى تشغيل نماذج كبيرة لكل رسالة أو تعليق. لكن حجم الوفر الفعلي سيعتمد على طريقة الدمج، والعتاد المستخدم، وحجم الطلبات، وكلفة الأخطاء، وليس على سرعة النموذج وحدها.
وتشير بطاقة النموذج أيضاً إلى حدود مهمة. فـ«موسوبي لابس» تقول إن النموذج خارج نطاق الاستخدام في إنفاذ قضايا سلامة الأطفال، أو كأداة وحيدة للتعامل مع إيذاء النفس، أو كحاجز أمني ضد المستخدمين العدائيين. كما توضح أنه أضعف مع بعض اللغات الأقل تمثيلاً، والنصوص المموهة، والرسائل الطويلة.
لذلك، لا يعني انتقال مراقبة المحتوى نحو الأتمتة خروج الإنسان من العملية. بل الأقرب أن تتحول المراجعة البشرية إلى مرحلة أكثر تركيزاً على الحالات الرمادية، والاعتراضات، والقرارات الحساسة التي تحتاج إلى فهم السياق.
بهذا المعنى، يمثل «PolicyLM» مثالاً على اتجاه أوسع في الذكاء الاصطناعي: نماذج أصغر وأكثر تخصصاً، لا تحاول فعل كل شيء، بل تنفذ مهمة محددة بسرعة وعلى نطاق واسع.
وإذا استمر هذا الاتجاه، فقد تنتقل المنافسة في سوق الثقة والسلامة من سؤال «من يملك أكبر نموذج؟» إلى سؤال أكثر عملية: من يستطيع اتخاذ القرار الأنسب، بأسرع وقت، وبأقل كلفة، من دون التخلي عن الرقابة البشرية عندما يصبح السياق معقداً؟
هذا المحتوى مقدم من إرم بزنس